


 USD


/ 10

Ringkasan
Ulasan ini membahas di mana ScrapeOps memberikan nilai operasional yang nyata, di mana platformnya masih terasa terbatas, dan tim developer mana yang paling berpeluang mendapat manfaat dari agregasi proxy serta stack monitoring-nya.
Kelebihan
Kekurangan
ScrapeOps Skor Ulasan
Review ScrapeOps: Infrastruktur Web Scraping Tanpa Repot Mengurus Banyak Vendor
ScrapeOps bukan aplikasi scraping no-code, dan bukan pula agen AI yang bisa menarik data bersih dari internet secara ajaib. Ini adalah infrastruktur untuk developer, ditujukan bagi tim yang sudah menjalankan scraper dan lelah mengurus proxy, parser yang rusak, penjadwalan, dan visibilitas job. Perbedaan ini penting. ScrapeOps tampak paling kuat ketika scraping sudah menjadi bagian dari alur kerja Anda dan masalahnya bersifat operasional, bukan konseptual.
Apa Itu ScrapeOps?
ScrapeOps adalah platform DevOps untuk web scraping yang dibangun di sekitar empat fungsi utama: agregasi proxy, monitoring scraper, penjadwalan job, dan parsing HTML ke JSON.
Versi sederhananya: platform ini membantu developer menjaga scraper di lingkungan produksi tetap berjalan.
Alih-alih membeli dan mengelola beberapa penyedia proxy secara terpisah, ScrapeOps menyediakan satu endpoint proxy yang merutekan permintaan melalui beberapa penyedia. Alih-alih memeriksa secara manual apakah Scraper gagal, platform ini menambahkan monitoring, peringatan, dan pelacakan kesehatan job. Alih-alih terus menulis ulang parser untuk situs e-commerce atau listing berskala besar, Parser API-nya dapat mengembalikan JSON terstruktur untuk target yang didukung.
Kategori yang paling tepat untuk produk ini adalah infrastruktur web scraping. AI Scraper Builder menambahkan lapisan pembuatan kode berbantuan AI, tetapi menyebut ScrapeOps sebagai platform agen AI akan menyesatkan. Produk intinya tetap berupa "pipa saluran" untuk developer.
Itu bukan kelemahan. Itulah jalur sebenarnya dari produk ini.
Bagaimana Cara Kerja ScrapeOps?
ScrapeOps terhubung ke alur kerja scraping yang sudah ada, bukan menggantikannya.
Developer dapat menggunakan Proxy API dengan merutekan permintaan melalui ScrapeOps menggunakan API key. Dari sana, ScrapeOps menangani pemilihan penyedia, percobaan ulang, rotasi IP, dan perutean anti-bot, tergantung pada paket dan target. Bagi tim yang sudah sering terkena pemblokiran proxy, nilai tambahnya jelas: satu endpoint menggantikan tumpukan akun proxy dan logika cadangan seadanya.
Monitoring membutuhkan integrasi yang lebih dalam. Pengguna Scrapy dapat menambahkan SDK dengan perubahan kecil pada pengaturan, sedangkan pengguna Python Requests perlu memasang integrasinya secara manual. Setelah terhubung, ScrapeOps melacak halaman yang di-scrape, item yang diekstrak, error, kode status, waktu eksekusi, dan tingkat keberhasilan. Peringatan dapat dikirim lewat email, Slack, atau webhook ketika performa job menurun.
Penjadwalan dan manajemen server berada di atas lapisan itu. Pengguna dapat menghubungkan server melalui SSH, menautkan repositori GitHub, men-deploy kode, memicu job, dan mengelola proses dari dashboard. Ini berguna jika armada scraping Anda tersebar di beberapa mesin dan cron job mulai menjadi beban tersembunyi.
Parser API bekerja dengan cara berbeda. Pengguna mengirim HTML mentah ke ScrapeOps, dan platform mengembalikan JSON terstruktur untuk situs yang didukung seperti Amazon, Walmart, eBay, Indeed, Redfin, dan mesin pencari. Ini bernilai, tetapi hanya jika situs target Anda termasuk dalam daftar parser yang didukung.
AI Scraper Builder lebih baru dan belum terbukti. Fitur ini menerima contoh URL lalu menghasilkan kode scraper Python atau Node.js menggunakan framework seperti BeautifulSoup, Scrapy, Selenium, Playwright, Cheerio, Axios, atau Puppeteer. Berguna, ya. Sepenuhnya matang, belum tentu. Fitur ini masih dalam tahap beta, dan hasil pembuatan scraper versi beta sebaiknya diperlakukan sebagai titik awal, bukan kebenaran untuk produksi.
Fitur Utama
- Fitur terpenting ScrapeOps adalah Proxy API Aggregator. Fitur ini mengubah masalah operasional yang berantakan menjadi lapisan perutean yang lebih rapi. Tim dapat mengakses beberapa penyedia proxy dari satu endpoint, tanpa berpindah-pindah vendor secara manual saat tingkat pemblokiran melonjak atau performa turun.
- Residential and Mobile Proxy Aggregator adalah versi yang lebih berat dari gagasan yang sama. Fitur ini mendukung HTTP dan SOCKS5, penargetan negara dan kota, sticky session, proxy rotasi, dan harga berbasis bandwidth. Bagi tim yang membutuhkan scraping berbasis lokasi, ini lebih penting daripada akses proxy generik.
- Produk monitoring adalah bagian besar kedua. Kegagalan scraping jarang terjadi secara dramatis. Biasanya membusuk perlahan: jumlah item turun, HTML berubah, pemblokiran meningkat, atau job mulai mengembalikan data sampah. ScrapeOps memberi tim dashboard dan lapisan peringatan agar kegagalan tersebut terlihat lebih awal.
- Parser API lebih sempit cakupannya tetapi praktis. Jika Anda men-scrape situs yang didukung, parser yang dipelihara dapat menghemat waktu engineering secara nyata. Nilainya bukan "ekstraksi AI". Nilainya adalah tim Anda tidak perlu menulis ulang selector setiap kali tata letak halaman ritel berubah.
- AI Scraper Builder adalah fitur yang paling menarik sebagai headline, tetapi belum tentu yang terpenting. Membuat scraper boilerplate dari contoh URL dapat mempercepat pekerjaan awal, terutama untuk halaman produk dan halaman kategori. Kendalanya jelas: kode scraper hasil generate tetap perlu ditinjau, diuji, dan dipelihara. Siapa pun yang mengklaim sebaliknya hanya menjual angan-angan.
- MCP server menarik tetapi kurang dijelaskan secara publik. Sebelum kasus penggunaan dan tool yang tersedia menjadi lebih jelas, fitur ini sebaiknya dianggap sebagai sinyal awal, bukan alasan untuk membeli.
Pengaturan dan Onboarding
ScrapeOps memiliki dua wajah dalam hal pengaturan.
Untuk akses proxy, onboarding terasa ringan. Dapatkan API key, rutekan permintaan melalui endpoint, lalu mulai menguji. Itulah jalur dengan hambatan paling rendah.
Untuk monitoring dan penjadwalan, produk ini menjadi lebih teknis. Pengguna Scrapy mendapat jalur termudah karena integrasinya kecil. Pengguna Python Requests masih menghadapi kurva pengaturan yang wajar. Tim yang menggunakan Node.js, Selenium, Playwright, atau Puppeteer untuk monitoring belum mendapatkan tingkat kematangan yang sama, karena integrasi monitoring tersebut belum dirilis sepenuhnya.
Beban pengaturan yang lebih besar muncul pada penjadwalan dan manajemen server. Akses SSH, tautan repositori GitHub, izin deployment, dan kontrol job produksi bukanlah langkah onboarding yang sepele. Di sinilah tim yang serius mungkin melihat nilainya, tetapi juga di sinilah pengguna non-teknis akan mundur.
Itulah pertukaran yang sebenarnya: pengujian ringan itu mudah, tetapi adopsi yang berarti membutuhkan kepemilikan dari sisi developer.
Kasus Penggunaan di Dunia Nyata
ScrapeOps paling cocok untuk kondisi di mana scraping sudah menjadi kebutuhan bisnis yang krusial.
Developer Python yang menjalankan spider Scrapy dapat menggunakannya untuk memantau kesehatan job tanpa membangun stack observability sendiri. Ini mungkin kecocokan yang paling ideal.
Tim data yang men-scrape situs e-commerce dapat memakai proxy aggregator untuk mengurangi repotnya mengurus banyak vendor, dan Parser API untuk mendapatkan data produk terstruktur dari situs yang didukung. Ini praktis untuk pemantauan harga, product intelligence, dan pelacakan marketplace.0
Kontraktor scraping dapat menggunakan ScrapeOps sebagai lapisan proxy dengan biaya terkendali tanpa terikat pada satu vendor. Ini penting ketika target klien beragam dan satu penyedia proxy tidak berkinerja sama baiknya di semua tempat.
Tim yang menjalankan scraper di beberapa server dapat memakai dashboard untuk menjadwalkan, menjalankan ulang, menjeda, dan men-deploy job tanpa bergantung pada cron job yang tersebar dan pekerjaan SSH manual.
AI Scraper Builder berada lebih awal dalam alur kerja: menghasilkan kode awal dari contoh URL. Berguna untuk bergerak lebih cepat, tetapi tidak menghilangkan kebutuhan akan penilaian dari engineer.
Siapa yang Paling Cocok Menggunakan ScrapeOps?
ScrapeOps paling cocok untuk tim scraping berbasis Python yang sudah paham apa yang mereka kerjakan dan ingin lebih sedikit kerumitan operasional.
Platform ini cocok untuk:
- Developer Scrapy yang membutuhkan monitoring dengan pengaturan minimal
- Tim data engineering yang mengelola banyak job scraping
- Kontraktor yang membutuhkan akses proxy fleksibel di berbagai target
- Tim intelijen e-commerce dan marketplace yang men-scrape situs yang didukung
- Tim teknis kecil yang membutuhkan infrastruktur scraping produksi tanpa harga tingkat enterprise
Target idealnya bukan "siapa saja yang menginginkan data web". Target idealnya adalah developer dan tim yang sudah cukup sering melakukan scraping sehingga kegagalan proxy, pemeliharaan parser, dan celah monitoring memakan waktu mereka.
Siapa yang Sebaiknya Menghindari ScrapeOps?
- Pengguna non-teknis sebaiknya melewatkannya. ScrapeOps tidak menghilangkan kebutuhan untuk memahami scraping, perilaku HTTP, struktur situs, atau dasar-dasar deployment.
- Tim yang mencari layanan scraping terkelola penuh mungkin juga kecewa. ScrapeOps membungkus scraper yang Anda bangun dan jalankan sendiri. Ini bukan kemudahan ala marketplace actor seperti Apify, dan bukan penyedia data siap pakai.
- Tim yang mengutamakan Node.js sebaiknya berhati-hati jika monitoring adalah alasan utama mereka. Akses proxy dan pembuatan kode AI mendukung alur kerja Node.js, tetapi monitoring masih paling kuat di Python.
- Pembeli enterprise yang membutuhkan detail SLA publik, sertifikasi keamanan, kejelasan data residency, atau dokumentasi kepatuhan yang mendalam mungkin menganggap lapisan kepercayaannya tipis. Itu tidak berarti produknya tidak andal. Artinya, bukti yang ada belum cukup untuk menjadi dasar kepercayaan tingkat enterprise.
Kelebihan
- Kekuatan terbesarnya adalah konsolidasi operasional. Manajemen proxy, monitoring, pemeliharaan parser, dan penjadwalan adalah masalah yang terpisah. ScrapeOps menyatukan beberapa di antaranya dalam satu dashboard yang praktis.
- Paket gratisnya luar biasa berguna. Kredit proxy, bandwidth residential, kredit parser, dan monitoring gratis menurunkan biaya evaluasi. Ini penting dalam scraping, di mana demo penjualan tidak sebanding dengan melihat langsung apakah sebuah target benar-benar berfungsi.
- Kejelasan harga adalah keunggulan nyata lainnya. Paket standar dipublikasikan, harga awalnya terjangkau, dan tim dapat memahami model harganya sebelum berbicara dengan tim sales.
- Dukungan Scrapy menjadi pintu masuk yang kuat. Pengaturan monitoring tiga baris adalah jalur adopsi yang memang bisa diterima developer.
- Proxy aggregator juga memberi manfaat tajam bagi pembeli: mengurangi ketergantungan pada satu penyedia. Dalam scraping, vendor lock-in bukan sekadar risiko komersial. Ini adalah risiko operasional.
Kekurangan
- Kelemahan terbesarnya adalah cakupan stack. Monitoring masih berpusat pada Python. Jika scraping produksi Anda berjalan di Node.js atau framework headless browser, cerita monitoring platform ini belum cukup meyakinkan.
- Cakupan parser juga sempit. Amazon, Walmart, eBay, Indeed, Redfin, dan mesin pencari adalah target yang berguna, tetapi itu bukan lapisan parsing universal. Jika situs penting Anda berada di luar daftar itu, Anda kembali harus memelihara parser sendiri.
- AI Scraper Builder menjanjikan tetapi belum matang sebagai penentu keputusan. Akses beta, skema yang terbatas, dan performa yang belum pasti pada halaman kompleks menjadikannya eksperimen yang berguna, bukan alasan utama untuk membeli.
- Validasi pihak ketiga masih tipis. Sedikitnya ulasan publik belum cukup untuk membuat klaim kuat tentang keandalan pada skala besar. Untuk deployment yang serius, tim sebaiknya menjalankan pengujian sendiri pada target spesifik sebelum berkomitmen.
- Sinyal kepercayaan enterprise juga minim. Halaman publik tidak menampilkan secara menonjol detail keamanan, kepatuhan, SLA, atau retensi data yang sering dibutuhkan perusahaan besar. Celah ini semakin berarti seiring meningkatnya volume scraping dan paparan risiko internal.
Harga dan Paket
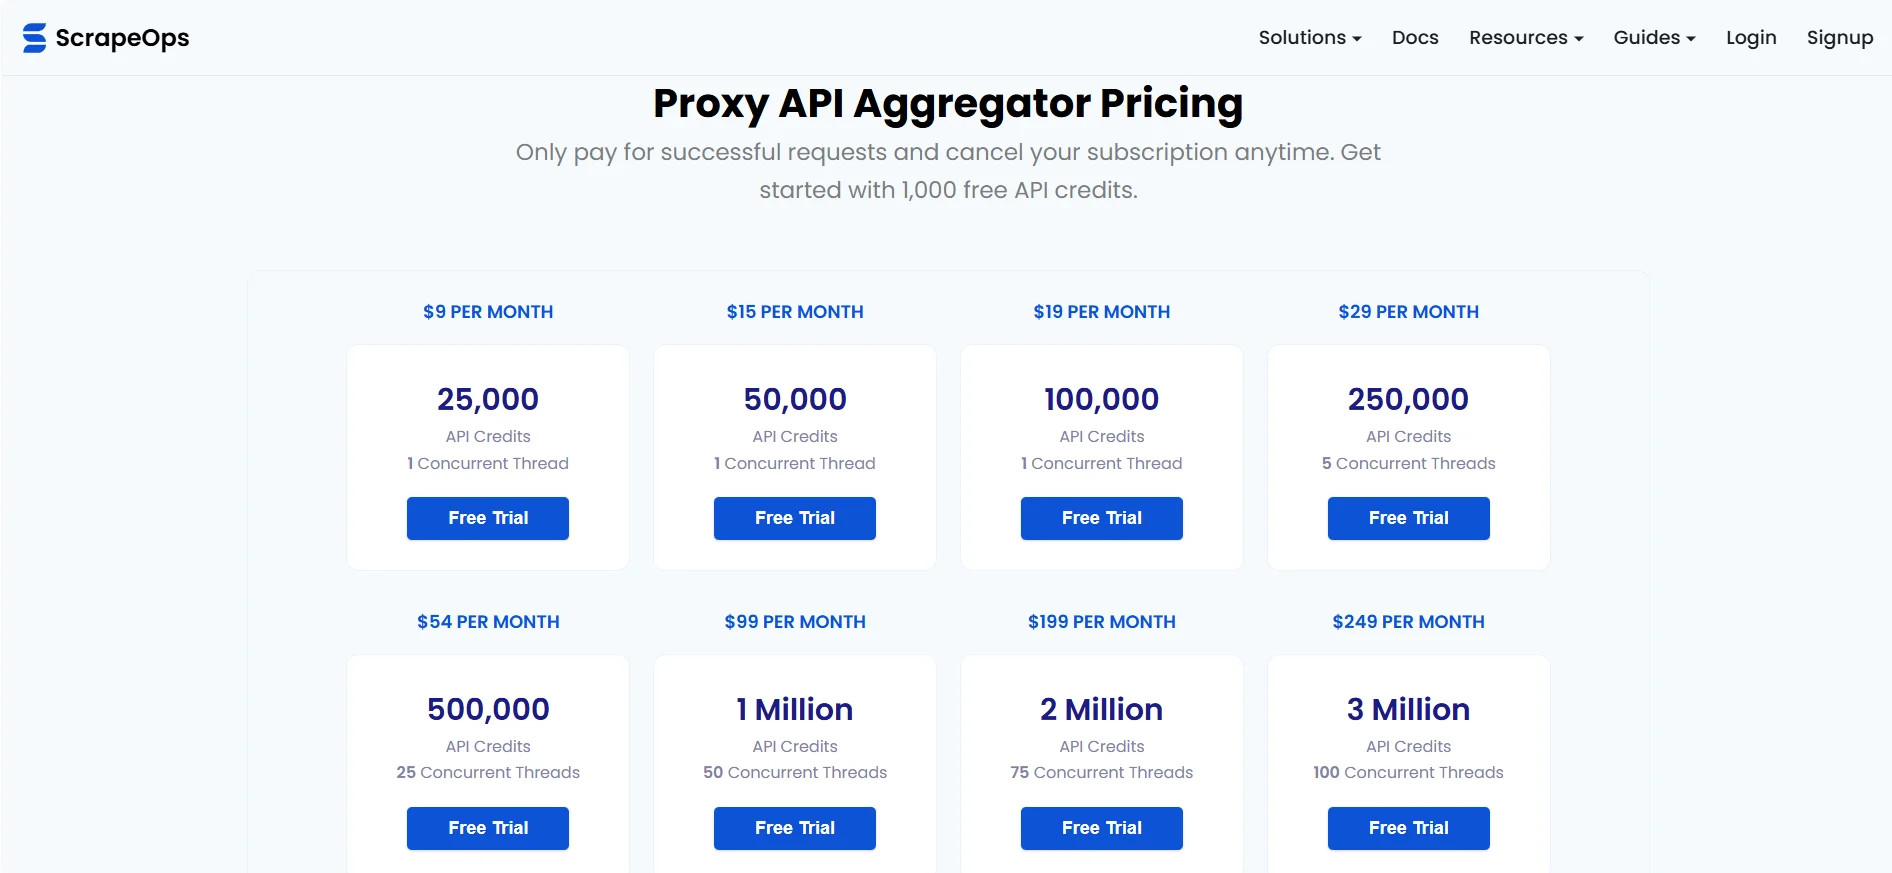
Harga ScrapeOps lebih jelas dibandingkan sebagian besar vendor infrastruktur scraping.
Proxy API Aggregator dimulai dari $9 per bulan, dengan tingkat lebih tinggi yang menyesuaikan kredit API. Residential Proxy Aggregator dimulai dengan paket gratis 100MB dan paket berbayar mulai dari $15 per bulan. Monitoring memiliki paket komunitas gratis, lalu paket berbayar mulai dari $4.95 per bulan. Paket Parser API dimulai dari $5 per bulan.
Model harganya bergantung pada produknya:
- Harga Proxy API didasarkan pada kredit permintaan yang berhasil.
- Harga residential proxy didasarkan pada bandwidth.
- Harga monitoring didasarkan pada volume halaman dan tingkat fitur.
- Harga Parser API didasarkan pada parsing yang berhasil.
Ini masuk akal, tetapi juga berarti tim perlu memahami pola penggunaan mereka sebelum memperkirakan pengeluaran bulanan. Tim yang melakukan monitoring ringan mungkin nyaris tidak mengeluarkan biaya. Tim yang men-scrape halaman e-commerce bervolume tinggi melalui residential proxy akan jauh lebih memperhatikan bandwidth dan tingkat keberhasilan.
Paket ini paling kuat untuk developer dan tim kecil karena titik masuknya rendah dan paket gratisnya cukup nyata untuk diuji. Harga enterprise kurang transparan karena paket kustom mengharuskan Anda menghubungi tim penjualan.
Perbandingan ScrapeOps dengan Alternatif
ScrapeOps berada di jalur yang berbeda dari banyak alternatif yang umum.
- Dibandingkan dengan Zyte, ScrapeOps terlihat lebih ringan dan modular. Zyte menawarkan stack scraping terkelola yang lebih luas, termasuk infrastruktur cloud scraping. ScrapeOps lebih tepat digambarkan sebagai toolkit di sekitar scraper yang sudah Anda jalankan. Jika Anda menginginkan infrastruktur yang lebih terkelola, Zyte mungkin pembanding yang lebih natural. Jika Anda menginginkan agregasi proxy plus monitoring tanpa komitmen platform yang lebih berat, ScrapeOps punya penawaran yang lebih rapi.
- Dibandingkan dengan ScraperAPI, ScrapeOps lebih luas. ScraperAPI terutama merupakan produk API proxy dan scraping. ScrapeOps mencakup agregasi proxy, tetapi menambahkan monitoring, penjadwalan, parser API, dan dashboard untuk operasional scraper produksi. ScraperAPI mungkin lebih menarik bagi tim yang menginginkan API proxy dari satu vendor. ScrapeOps lebih menarik ketika redundansi dan observability dianggap penting.
- Dibandingkan dengan Bright Data, ScrapeOps lebih mudah diakses tetapi kurang berorientasi enterprise. Bright Data adalah platform proxy dan pengumpulan data besar dengan positioning enterprise yang lebih dalam. ScrapeOps mengagregasi akses ke penyedia seperti Bright Data, bukan menggantikan seluruh kategori tersebut. Bagi tim teknis yang lebih kecil, itu bisa menjadi poin utamanya.
- Dibandingkan dengan Apify, perbedaannya ada pada kepemilikan alur kerja. Apify menyediakan actor terkelola, marketplace, proses cloud, dan dataset. ScrapeOps mengharapkan pengguna memiliki logika scraper dan infrastrukturnya sendiri. Apify lebih mudah bagi tim yang menginginkan alur kerja scraping siap pakai. ScrapeOps lebih baik bagi tim yang sudah menulis scraper sendiri dan menginginkan dukungan infrastruktur.
Kesimpulan Akhir
ScrapeOps layak dicoba jika Anda sudah menjalankan scraper produksi dan bagian-bagian yang merepotkan mulai membebani tim Anda: pergantian proxy, celah monitoring, pemeliharaan parser, dan penjadwalan job yang tersebar.
Ini bukan alat yang tepat untuk pengguna non-teknis, kebutuhan scraping kasual, atau tim yang mengharapkan layanan ekstraksi data terkelola penuh. Platform ini juga sebaiknya tidak dibeli hanya karena AI Scraper Builder. Fitur tersebut mungkin menjadi berguna, tetapi nilai yang sudah matang masih ada pada infrastruktur scraping.
Kecocokan terkuatnya adalah tim scraping berbasis Python yang menginginkan kontrol operasional lebih baik tanpa masuk ke platform enterprise yang besar. Kompromi utamanya ada pada keluasan kematangan: ScrapeOps tajam di jalur intinya, tetapi beberapa bagian yang lebih baru atau lebih luas masih membutuhkan dokumentasi yang lebih kuat, lebih banyak integrasi, dan lebih banyak validasi publik.
Bagi tim developer yang tepat, ScrapeOps layak masuk daftar pilihan. Bagi yang lain, ini mungkin lebih banyak infrastruktur daripada yang sebenarnya mereka butuhkan.
FAQ
- Untuk apa ScrapeOps digunakan?
ScrapeOps digunakan untuk mengelola infrastruktur web scraping produksi. Kasus penggunaan utamanya meliputi agregasi proxy, monitoring scraper, penjadwalan job, manajemen server, dan parsing HTML menjadi JSON terstruktur untuk situs web yang didukung.
- Apakah ScrapeOps merupakan alat scraping no-code?
Bukan. ScrapeOps berfokus pada developer. Pengguna tetap perlu membangun dan menjalankan scraper sendiri, meskipun AI Scraper Builder dapat menghasilkan kode scraper awal untuk beberapa kasus penggunaan.
- Siapa yang sebaiknya menggunakan ScrapeOps?
ScrapeOps paling cocok untuk developer, tim data, dan kontraktor scraping yang menjalankan scraper berbasis Python, Scrapy, atau Requests di lingkungan produksi. Platform ini sangat berguna ketika keandalan proxy, monitoring, dan pemeliharaan parser mulai menjadi masalah operasional.
- Apakah ScrapeOps menawarkan paket gratis?
Ya. ScrapeOps memiliki beberapa titik masuk gratis, termasuk kredit proxy, bandwidth residential proxy, kredit parser, dan paket monitoring komunitas gratis.
- Apa saja alternatif utama ScrapeOps?
Alternatif yang relevan mencakup Zyte, ScraperAPI, Bright Data, Apify, dan Scrapfly. Pilihan yang tepat tergantung pada apakah pengguna menginginkan scraping terkelola, akses proxy, hosting scraper, actor marketplace, atau infrastruktur developer di sekitar scraper yang sudah ada.
Pengungkapan: Artikel ini mungkin berisi tautan afiliasi. Jika Anda mendaftar melalui tautan tersebut, Coin360 dapat memperoleh komisi tanpa biaya tambahan bagi Anda. Hal ini tidak memengaruhi standar editorial kami, dan ulasan ditulis dengan mengutamakan akurasi, kegunaan, dan nilai bagi pembaca.


