


 USD


/ 10

Resumo
Esta análise mostra onde o ScrapeOps entrega valor operacional de verdade, onde sua plataforma ainda parece limitada e quais equipes de desenvolvimento têm mais chances de se beneficiar de sua stack de agregação de proxies e monitoramento.
Prós
Contras
ScrapeOps Notas da análise
Análise do ScrapeOps: infraestrutura de web scraping sem o malabarismo entre fornecedores
O ScrapeOps não é um app de scraping no-code nem um agente de IA que extrai dados limpos da internet como num passe de mágica. É uma infraestrutura para desenvolvedores, voltada a equipes que já operam scrapers e estão cansadas de cuidar de proxies, quebras de parsers, agendamentos e visibilidade de jobs. Essa distinção importa. O ScrapeOps se destaca quando o scraping já faz parte do seu fluxo de trabalho e o problema é operacional, não conceitual.
O que é o ScrapeOps?
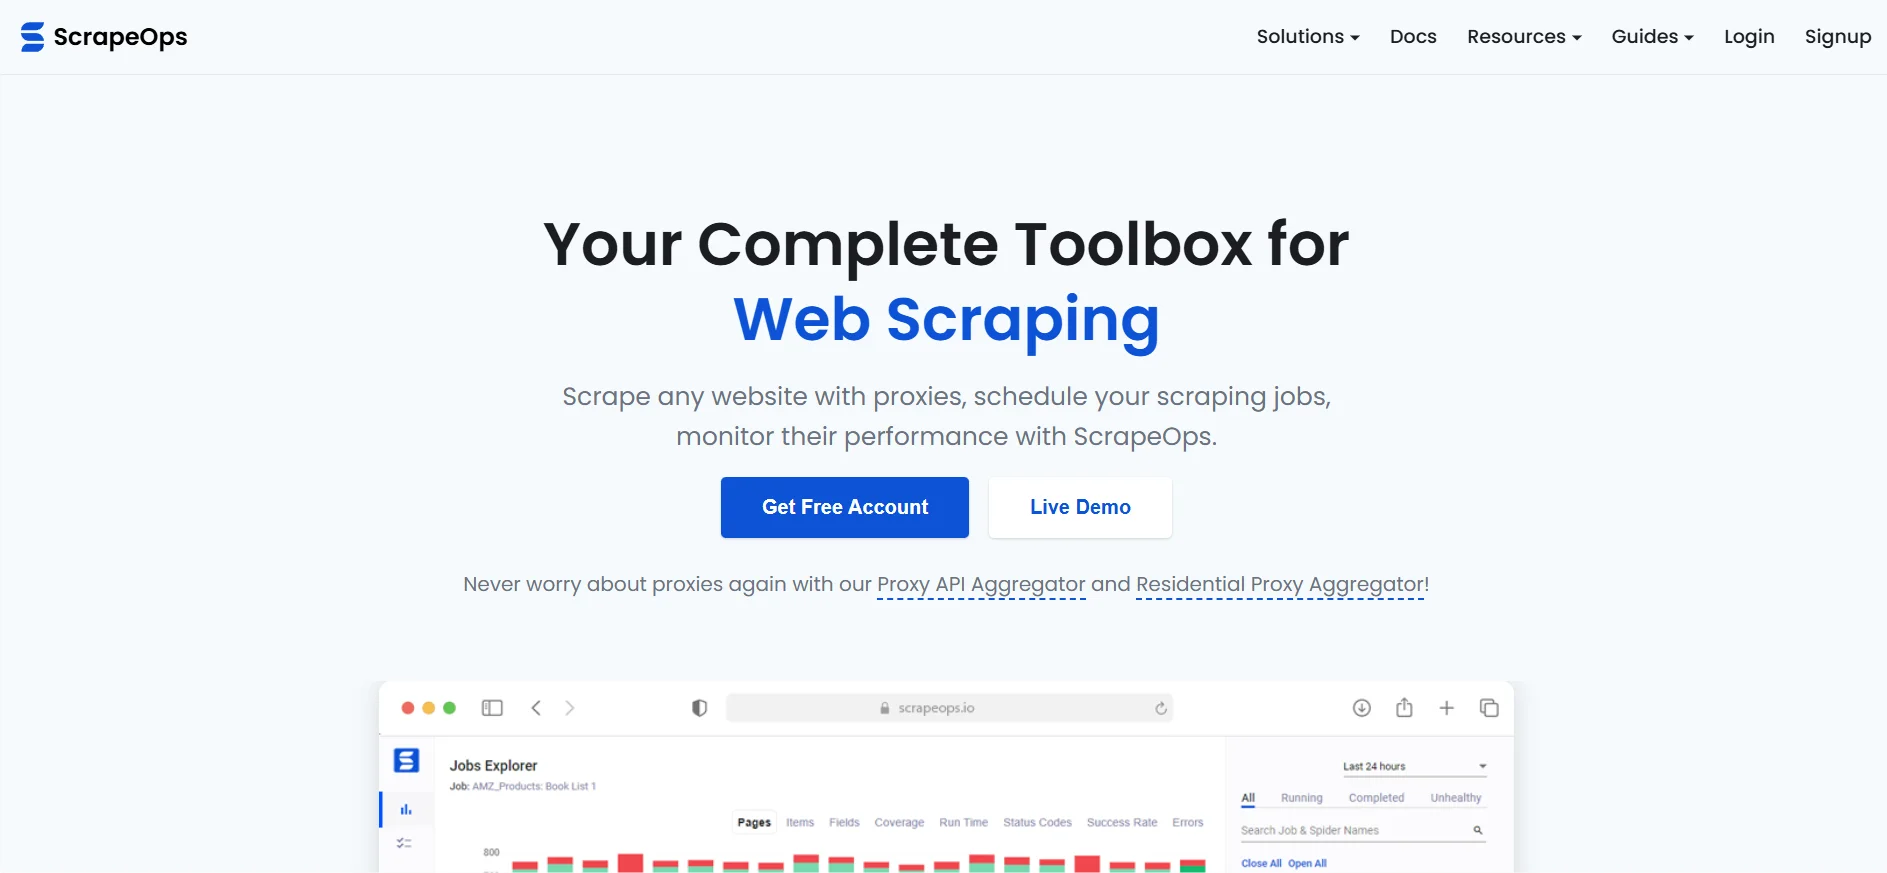
O ScrapeOps é uma plataforma de DevOps para web scraping construída em torno de quatro funções principais: agregação de proxies, monitoramento de scrapers, agendamento de jobs e conversão de HTML em JSON (parsing).
Em resumo: ele ajuda desenvolvedores a manter scrapers de produção funcionando.
Em vez de comprar e gerenciar vários provedores de proxy separadamente, o ScrapeOps oferece um único endpoint de proxy que direciona as requisições por vários provedores. Em vez de verificar manualmente se os scrapers estão falhando, ele adiciona monitoramento, alertas e acompanhamento da saúde dos jobs. E em vez de reescrever parsers o tempo todo para grandes sites de e-commerce ou de anúncios, sua Parser API pode retornar JSON estruturado para os alvos compatíveis.
A categoria é melhor descrita como infraestrutura de web scraping. O AI Scraper Builder adiciona uma camada de geração de código assistida por IA, mas chamar o ScrapeOps de plataforma de agentes de IA seria enganoso. O produto central continua sendo a "encanação" para desenvolvedores.
Isso não é uma fraqueza. É a verdadeira especialidade do produto.
Como o ScrapeOps funciona?
O ScrapeOps se encaixa nos fluxos de scraping existentes em vez de substituí-los.
O desenvolvedor pode usar a Proxy API direcionando as requisições pelo ScrapeOps com uma chave de API. A partir daí, o ScrapeOps cuida da seleção de provedores, das novas tentativas, da rotação de IPs e do roteamento anti-bot, dependendo do plano e do alvo. Para equipes que já lidam com bloqueios de proxy, o valor é óbvio: um único endpoint no lugar de uma pilha de contas de proxy e de lógicas de fallback remendadas.
O monitoramento exige uma integração mais profunda. Quem usa Scrapy pode adicionar o SDK com uma pequena alteração nas configurações, enquanto quem usa Python Requests precisa conectar a integração manualmente. Depois de conectado, o ScrapeOps acompanha páginas coletadas, itens extraídos, erros, códigos de status, tempos de execução e taxas de sucesso. Os alertas podem ser enviados por e-mail, Slack ou webhook quando os jobs começam a se degradar.
O agendamento e o gerenciamento de servidores ficam por cima disso. Os usuários podem conectar servidores por SSH, vincular repositórios do GitHub, fazer deploy de código, disparar jobs e gerenciar execuções pelo painel. Isso é útil se a sua frota de scrapers está espalhada por várias máquinas e os cron jobs estão virando um passivo silencioso.
A Parser API funciona de outra forma. Os usuários enviam HTML bruto ao ScrapeOps, e a plataforma devolve JSON estruturado para sites compatíveis, como Amazon, Walmart, eBay, Indeed, Redfin e mecanismos de busca. Isso é valioso, mas só se os seus sites-alvo estiverem na lista de parsers compatíveis.
O AI Scraper Builder é mais novo e menos comprovado. Ele recebe URLs de exemplo e gera código de scraper em Python ou Node.js usando frameworks como BeautifulSoup, Scrapy, Selenium, Playwright, Cheerio, Axios ou Puppeteer. Útil, sim. Totalmente maduro, talvez não. Ele ainda está em beta, e a geração de scrapers em beta deve ser tratada como ponto de partida, não como verdade de produção.
Principais recursos
- O recurso mais importante do ScrapeOps é o Proxy API Aggregator. Ele transforma um problema operacional bagunçado em uma camada de roteamento mais limpa. As equipes podem acessar vários provedores de proxy a partir de um único endpoint, em vez de alternar manualmente entre fornecedores quando as taxas de bloqueio disparam ou o desempenho cai.
- O Residential and Mobile Proxy Aggregator é a versão mais robusta dessa ideia. Ele oferece suporte a HTTP e SOCKS5, segmentação por país e cidade, sticky sessions, proxies rotativos e preços baseados em largura de banda. Para equipes que precisam de scraping específico por localização, isso importa mais do que um acesso genérico a proxies.
- O produto de monitoramento é a segunda grande peça. Falhas de scraping raramente são dramáticas. Em geral, elas apodrecem aos poucos: a contagem de itens cai, o HTML muda, os bloqueios aumentam ou os jobs começam a retornar lixo. O ScrapeOps oferece às equipes um painel e uma camada de alertas para que essas falhas fiquem visíveis mais cedo.
- A Parser API é mais restrita, mas prática. Se você coleta dados de sites compatíveis, parsers mantidos por terceiros podem economizar um tempo de engenharia real. O valor não está na "extração por IA". O valor está em não precisar que a sua equipe reescreva seletores toda vez que uma página de varejo muda de layout.
- O AI Scraper Builder é o recurso mais chamativo, mas não necessariamente o mais importante. Gerar scrapers-base a partir de URLs de exemplo pode acelerar o trabalho inicial, especialmente em páginas de produto e de categoria. A pegadinha é óbvia: o código de scraper gerado ainda precisa de revisão, testes e manutenção. Quem diz o contrário está vendendo pó de pirlimpimpim.
- O servidor MCP é interessante, mas pouco explicado publicamente. Até que os casos de uso e os recursos expostos fiquem mais claros, ele deve ser visto como um sinal inicial, não como um motivo de compra.
Configuração e onboarding
O ScrapeOps tem uma personalidade dividida quando o assunto é configuração.
Para acesso a proxies, o onboarding é leve. Basta obter uma chave de API, direcionar as requisições pelo endpoint e começar a testar. Esse é o caminho de baixo atrito.
Para monitoramento e agendamento, o produto fica mais técnico. Usuários de Scrapy têm o caminho mais fácil, porque a integração é pequena. Usuários de Python Requests ainda enfrentam uma curva de configuração razoável. Equipes que usam Node.js, Selenium, Playwright ou Puppeteer para monitoramento ainda não contam com a mesma maturidade, já que essas integrações de monitoramento não foram totalmente lançadas.
O maior esforço de configuração vem com o agendamento e o gerenciamento de servidores. Acesso SSH, vínculo com repositórios do GitHub, permissões de deploy e controle de jobs em produção não são etapas casuais de onboarding. É exatamente aí que equipes experientes podem enxergar valor, mas também onde usuários não técnicos vão desistir.
Esse é o verdadeiro trade-off: testar de forma leve é fácil, mas uma adoção significativa exige um desenvolvedor responsável pela ferramenta.
Casos de uso no mundo real
O ScrapeOps se encaixa melhor onde o scraping já é crítico para o negócio.
Um desenvolvedor Python que roda spiders do Scrapy pode usá-lo para monitorar a saúde dos jobs sem construir uma stack interna de observabilidade. Esse é provavelmente o encaixe mais limpo.
Uma equipe de dados que coleta informações de sites de e-commerce pode usar o agregador de proxies para reduzir o malabarismo entre fornecedores e a Parser API para obter dados estruturados de produtos em sites compatíveis. Isso é prático para monitoramento de preços, inteligência de produtos e acompanhamento de marketplaces.0
Um prestador de serviços de scraping pode usar o ScrapeOps como uma camada de proxy com custo controlado, sem se comprometer com um único fornecedor. Isso importa quando os alvos dos clientes variam e um provedor de proxy não tem o mesmo desempenho em todos os lugares.
Equipes que rodam scrapers em vários servidores podem usar o painel para agendar, reexecutar, pausar e fazer deploy de jobs sem depender de cron jobs espalhados e de trabalho manual via SSH.
O AI Scraper Builder entra mais no início do fluxo: gerar código inicial a partir de URLs de exemplo. É útil para ganhar velocidade, mas não elimina a necessidade de critério de engenharia.
Para quem o ScrapeOps é mais indicado?
O ScrapeOps é ideal para equipes de scraping centradas em Python que já sabem o que estão fazendo e querem menos bagunça operacional.
Ele serve para:
- Desenvolvedores Scrapy que precisam de monitoramento com configuração mínima
- Equipes de engenharia de dados que gerenciam vários jobs de scraping
- Prestadores de serviço que precisam de acesso flexível a proxies em diferentes alvos
- Equipes de inteligência de e-commerce e marketplaces que coletam dados de sites compatíveis
- Pequenas equipes técnicas que precisam de infraestrutura de scraping para produção sem preços de nível enterprise
O público ideal não é "qualquer pessoa que queira dados da web". O público ideal são desenvolvedores e equipes que já fazem scraping em volume suficiente para que falhas de proxy, manutenção de parsers e lacunas de monitoramento estejam custando tempo.
Quem deve evitar o ScrapeOps?
- Usuários não técnicos provavelmente devem passar longe. O ScrapeOps não elimina a necessidade de entender scraping, o comportamento do HTTP, a estrutura dos sites ou o básico de deploy.
- Equipes que buscam um serviço de scraping totalmente gerenciado também podem se decepcionar. O ScrapeOps funciona em volta de scrapers que você mesmo constrói e opera. Ele não tem a conveniência de um marketplace de actors como o da Apify, e também não é um fornecedor de dados "pronto para uso".
- Equipes que priorizam Node.js devem ter cautela se o monitoramento for o principal motivo da busca. O acesso a proxies e a geração de código por IA oferecem suporte a fluxos em Node.js, mas o monitoramento ainda é mais forte em Python.
- Compradores corporativos que precisam de detalhes públicos de SLA, certificações de segurança, clareza sobre residência de dados ou documentação aprofundada de compliance podem achar a camada de confiança frágil. Isso não significa que o produto seja pouco confiável. Significa que as evidências não bastam, por si só, para sustentar a confiança de uma grande empresa.
Pontos fortes
- O maior ponto forte é a consolidação operacional. Gerenciamento de proxies, monitoramento, manutenção de parsers e agendamento são dores de cabeça separadas. O ScrapeOps reúne várias delas em um painel prático.
- Os planos gratuitos são incomumente úteis. Créditos de proxy, largura de banda residencial, créditos de parser e monitoramento gratuito reduzem o custo de avaliação. Isso importa em scraping, onde demonstrações comerciais valem menos do que ver se um alvo realmente funciona.
- A clareza de preços é outra vantagem real. Os planos padrão são públicos, os preços de entrada são acessíveis e as equipes conseguem entender o modelo de cobrança antes de falar com o time comercial.
- O suporte ao Scrapy é uma boa porta de entrada. Uma configuração de três linhas para monitoramento é exatamente o tipo de caminho de adoção que os desenvolvedores realmente toleram.
- O agregador de proxies também traz um benefício direto ao comprador: reduz a dependência de um único provedor. Em scraping, o vendor lock-in não é só um risco comercial. É um risco operacional.
Pontos fracos
- A maior fraqueza é a cobertura de stacks. O monitoramento ainda é centrado em Python. Se o seu scraping em produção roda em Node.js ou em frameworks de navegador headless, a proposta de monitoramento da plataforma ainda não é tão convincente.
- A cobertura de parsers também é restrita. Amazon, Walmart, eBay, Indeed, Redfin e mecanismos de busca são alvos úteis, mas isso não é uma camada de parsing universal. Se os seus sites importantes ficam fora dessa lista, você volta a manter os parsers por conta própria.
- O AI Scraper Builder é promissor, mas ainda imaturo como fator de decisão. Acesso em beta, esquemas limitados e desempenho incerto em páginas complexas fazem dele um experimento útil, não um motivo central de compra.
- A validação de terceiros é escassa. Um pequeno número de avaliações públicas não basta para afirmações fortes sobre confiabilidade em escala. Em implantações sérias, as equipes devem fazer seus próprios testes com os alvos específicos antes de se comprometer.
- Os sinais de confiança para empresas também são fracos. As páginas públicas não mostram de forma destacada o nível de detalhe sobre segurança, compliance, SLA ou retenção de dados que grandes empresas costumam exigir. Essa lacuna pesa mais à medida que o volume de scraping e a exposição a riscos internos aumentam.
Preços e planos
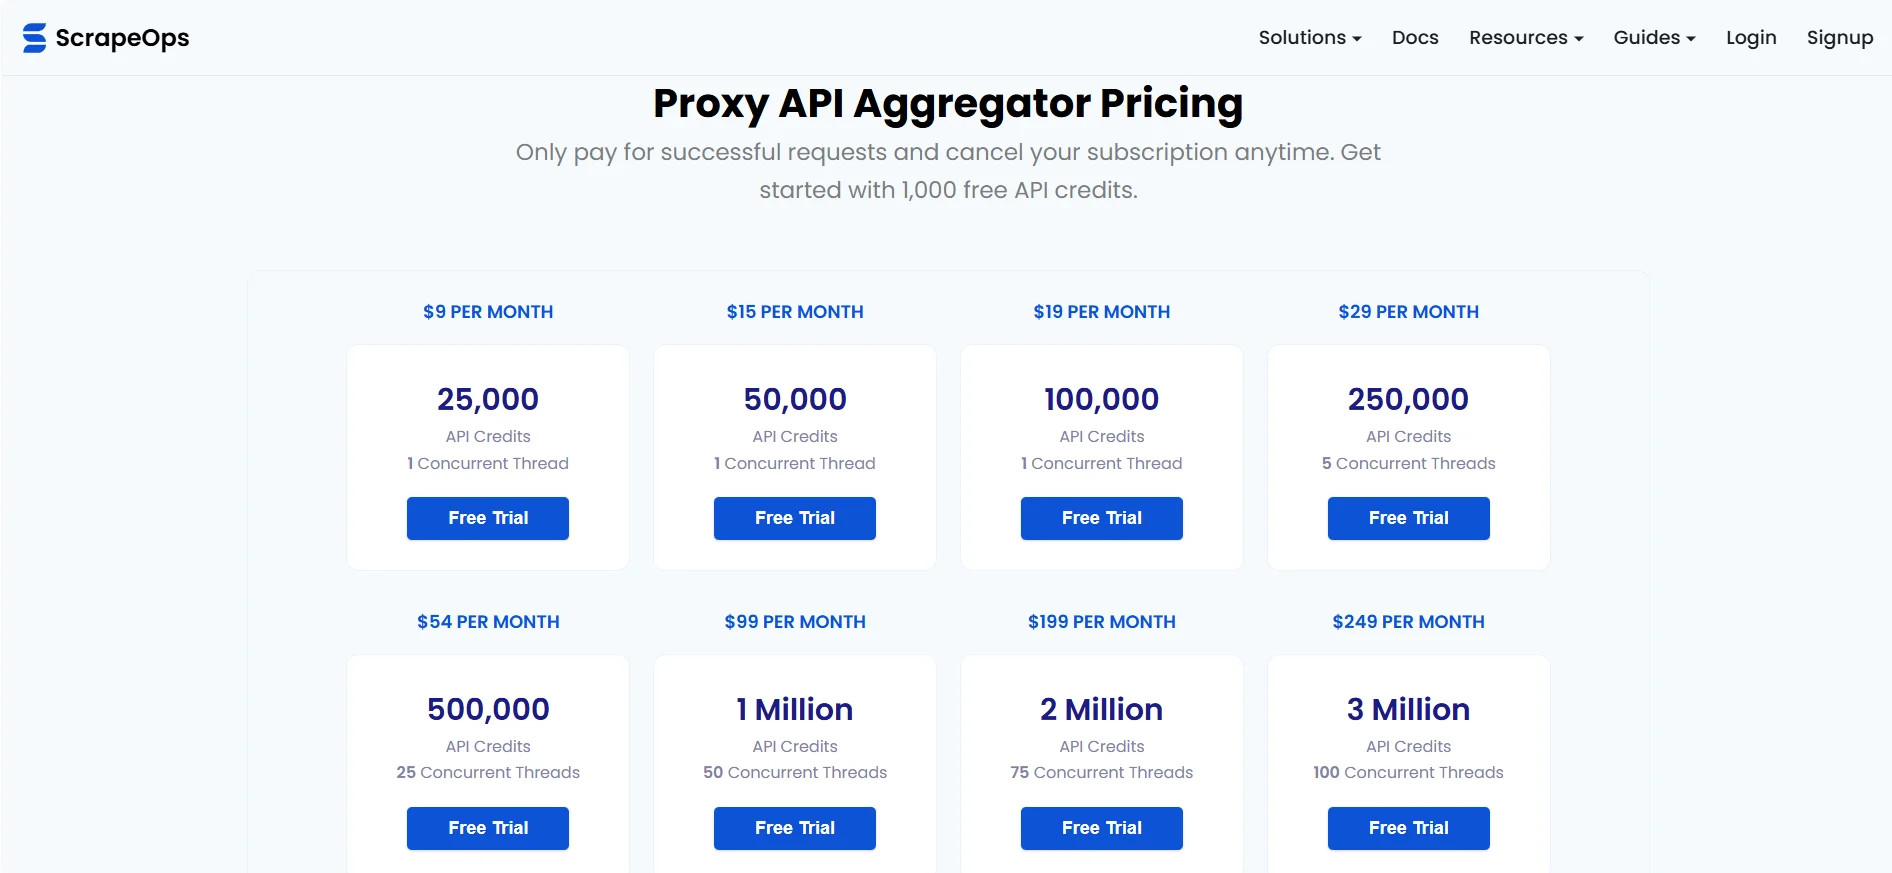
Os preços do ScrapeOps são mais claros do que os da maioria dos fornecedores de infraestrutura de scraping.
O Proxy API Aggregator começa em $9 por mês, com planos superiores escalando por créditos de API. O Residential Proxy Aggregator começa com um plano gratuito de 100MB e planos pagos a partir de $15 por mês. O monitoramento tem um plano comunitário gratuito e, depois, planos pagos a partir de $4.95 por mês. Os planos da Parser API começam em $5 por mês.
O modelo de preços depende do produto:
- O preço da Proxy API é baseado em créditos por requisições bem-sucedidas.
- O preço dos proxies residenciais é baseado em largura de banda.
- O preço do monitoramento é baseado no volume de páginas e no nível de recursos.
- O preço da Parser API é baseado em parsings bem-sucedidos.
Isso faz sentido, mas também significa que as equipes precisam entender seu padrão de uso antes de estimar o gasto mensal. Uma equipe com monitoramento leve pode gastar quase nada. Uma equipe que coleta páginas de e-commerce de alto volume por proxies residenciais vai se preocupar muito mais com largura de banda e taxas de sucesso.
O formato dos planos é mais vantajoso para desenvolvedores e pequenas equipes, porque as portas de entrada são baratas e os planos gratuitos são reais o bastante para testes. Os preços corporativos são menos transparentes, já que os planos personalizados exigem contato.
Como o ScrapeOps se compara às alternativas
O ScrapeOps atua em uma frente diferente da de muitas alternativas óbvias.
- Em comparação com a Zyte, o ScrapeOps parece mais leve e modular. A Zyte oferece uma stack de scraping gerenciada mais ampla, incluindo infraestrutura de scraping na nuvem. O ScrapeOps é melhor entendido como um kit de ferramentas em torno de scrapers que você já opera. Se você quer mais infraestrutura gerenciada, a Zyte pode ser a comparação mais natural. Se você quer agregação de proxies e monitoramento sem o compromisso de uma plataforma mais pesada, o ScrapeOps tem uma proposta mais enxuta.
- Em comparação com a ScraperAPI, o ScrapeOps é mais abrangente. A ScraperAPI é principalmente um produto de proxy e API de scraping. O ScrapeOps inclui agregação de proxies, mas acrescenta monitoramento, agendamento, Parser APIs e um painel para a operação de scrapers em produção. A ScraperAPI pode atrair mais as equipes que querem uma API de proxy de um único fornecedor. O ScrapeOps é mais atraente quando redundância e observabilidade importam.
- Em comparação com a Bright Data, o ScrapeOps é mais acessível, porém menos voltado ao mercado corporativo. A Bright Data é uma grande plataforma de proxies e coleta de dados, com um posicionamento corporativo mais forte. O ScrapeOps agrega o acesso a provedores como a Bright Data, em vez de substituir toda essa categoria. Para equipes técnicas menores, esse pode ser justamente o ponto.
- Em comparação com a Apify, a diferença está na propriedade do fluxo de trabalho. A Apify oferece actors gerenciados, um marketplace, execuções na nuvem e datasets. O ScrapeOps espera que os usuários sejam donos da lógica do scraper e da infraestrutura. A Apify é mais fácil para equipes que querem fluxos de scraping prontos. O ScrapeOps é melhor para equipes que já escrevem seus próprios scrapers e querem suporte de infraestrutura.
Veredito final
Vale a pena testar o ScrapeOps se você já roda scrapers em produção e as partes bagunçadas estão começando a sobrecarregar sua equipe: troca de proxies, pontos cegos de monitoramento, manutenção de parsers e agendamento de jobs espalhado.
Ele não é a ferramenta certa para usuários não técnicos, para necessidades casuais de scraping ou para equipes que esperam um serviço de extração de dados totalmente gerenciado. Também não deve ser contratado só por causa do AI Scraper Builder. Esse recurso pode se tornar útil, mas o valor maduro ainda está na infraestrutura de scraping.
O melhor encaixe é uma equipe de scraping centrada em Python que quer mais controle operacional sem aderir a uma grande plataforma corporativa. O principal trade-off é a amplitude da maturidade: o ScrapeOps é afiado em sua frente principal, mas algumas peças mais novas ou mais amplas ainda precisam de documentação mais sólida, mais integrações e mais validação pública.
Para a equipe de desenvolvimento certa, o ScrapeOps merece entrar na lista de finalistas. Para todos os outros, pode ser mais infraestrutura do que realmente se quer.
FAQ
- Para que serve o ScrapeOps?
O ScrapeOps é usado para gerenciar infraestrutura de web scraping em produção. Seus principais casos de uso incluem agregação de proxies, monitoramento de scrapers, agendamento de jobs, gerenciamento de servidores e conversão de HTML em JSON estruturado para sites compatíveis.
- O ScrapeOps é uma ferramenta de scraping no-code?
Não. O ScrapeOps é voltado para desenvolvedores. Os usuários ainda precisam construir e operar seus próprios scrapers, embora o AI Scraper Builder possa gerar código inicial de scraper para alguns casos de uso.
- Quem deve usar o ScrapeOps?
O ScrapeOps é ideal para desenvolvedores, equipes de dados e prestadores de serviços de scraping que rodam em produção scrapers baseados em Python, Scrapy ou Requests. Ele é especialmente útil quando a confiabilidade dos proxies, o monitoramento e a manutenção de parsers estão virando problemas operacionais.
- O ScrapeOps tem plano gratuito?
Sim. O ScrapeOps tem várias portas de entrada gratuitas, incluindo créditos de proxy, largura de banda de proxies residenciais, créditos de parser e um plano comunitário gratuito de monitoramento.
- Quais são as principais alternativas ao ScrapeOps?
Entre as alternativas relevantes estão Zyte, ScraperAPI, Bright Data, Apify e Scrapfly. A escolha certa depende de o usuário querer scraping gerenciado, acesso a proxies, hospedagem de scrapers, actors de marketplace ou infraestrutura para desenvolvedores em torno de scrapers já existentes.
Aviso: este artigo pode conter links de afiliados. Se você se cadastrar por meio deles, a Coin360 pode receber uma comissão sem nenhum custo extra para você. Isso não afeta nossos padrões editoriais, e as análises são escritas para priorizar precisão, utilidade e valor para o leitor.


